静态 vs 动态:防护盾只通过了一半的测试
发布日期: 2026-08-12
模拟结果 — 未使用真实资金。以下每一项数据均由回测根据历史价格数据计算得出。未投入任何资金,也未下过任何订单。回测是在完全知晓该时段结果的前提下把策略套用于过去,且数据不包含滑点与流动性影响,但会对每次再平衡、DCA 买入和资金重新部署收取 0.1% 的模拟交易所手续费。模拟表现与过往表现不能可靠地预示未来结果。AQMath 是软件,不是投资建议。
日期: 2026-08-12 引擎: Aegis(v14)去杠杆防护盾 — 与生产环境完全相同的代码,未做任何修改 状态: 门槛 2/4 — 防护盾赢下防护类指标(MaxDD、Calmar),但输掉收益类 门槛:机器人再平衡 60/40 的夏普更高,最终权益是它的两倍多 · 每个行为类 场景 30 个种子
60 秒速读
- 最简单的价值检验:防护盾能否击败一张餐巾纸就能画出来的静态 加密币/ 稳定币 分配?
- 跳出框架的设计:竞争者按三种"像人程度"分别测试 — 机器人 (每年再平衡)、抽屉党(从不触碰)与真人(疼到受不了就 投降)。
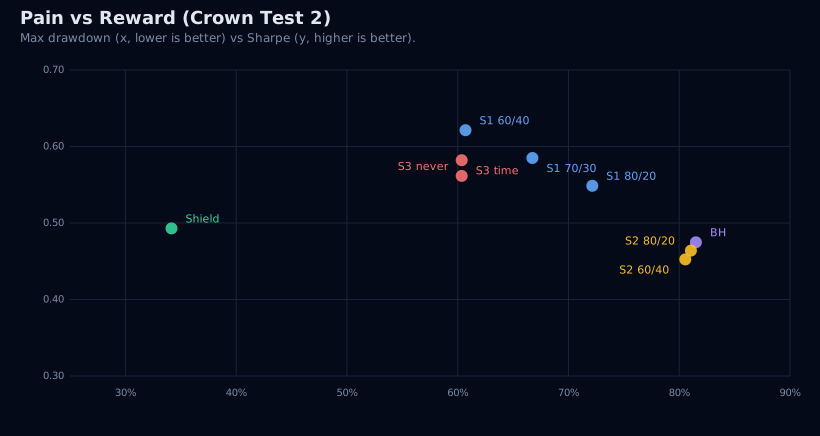
- 防护门槛通过:防护盾 MaxDD 34.2%,而每一个静态变体在 60.7–81.1% 之间;Calmar 是九个策略中最高的。
- 收益门槛失败:机器人 60/40 的夏普更高(0.621 对 0.493),最终权益 超过两倍。
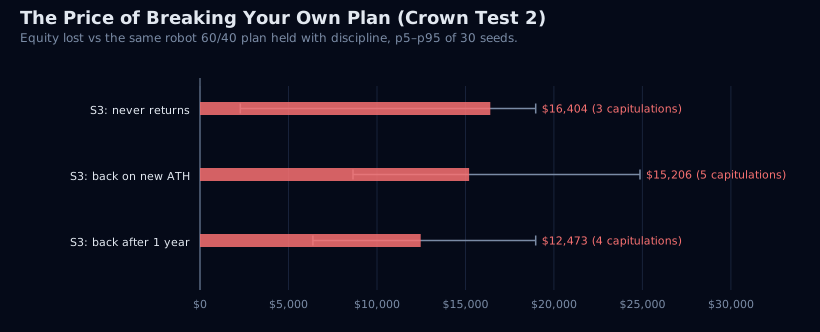
- 但机器人并不存在。同一个计划的"人类版本"每个都违约 3–5 次,每个 模拟生命周期放弃 $12.5k–$16.4k 的权益,而且约 81% 的时间都待在 稳定币里。
下文用到的术语: MaxDD(最大回撤) — 组合从最高点跌落的幅度。 夏普(Sharpe) — 每单位风险赚取的收益,越高越好。Calmar — 年化收益除以 MaxDD,即每承受一份痛苦换来的回报。
1. 目标
如果防护盾连一个简单策略都打不过 — 持有 X% 加密币、(100−X)% 稳定币 — 那它的所有复杂性都不必要。这是检验附加价值最干净的方式,也是计划中 的第二项皇冠测试。
人为因素系列的一个教训塑造了本次设计:机器人竞争者不是真正的 竞争者。 此前的测试把人为误差建模为机械随机性;人本身 — 恐惧、 恐慌、放弃 — 从未进入测试。一个在 60% 回撤面前眼皮都不眨的静态 60/40,是替代方案的最强版本。只击败那个版本说明不了什么;击败它以及 人类版本,才算真正的证据。
有一处不对称被摆在明面上,而非藏起来:静态分配拥有零操作面 — 没有会错过的信号,没有会迟到的执行。人为因素系列恰好度量了防护盾 一侧为此付出的代价。因此这次比较是"每单位所需纪律换来的防护", 文章对此直言不讳。
2. 设计
所有策略共享相同输入:组合 ADA、BNB、ETH、XRP、SOL(风险腿等权), 2020-04-10 至 2026-07-04(6.2 年、两轮熊市),$1,000 起步,每 30 天 $100 完美定投,每笔交易 0.1% 手续费,稳定币收益为零。定投维度保持 完美 — 抖动已在人为因素系列中测过。
| 策略 | 风险 | 稳定 | 行为 |
|---|---|---|---|
| BH | 100% | 0% | 买入持有基准 |
| S1 — 教科书(机器人) | 60/70/80% | 其余 | 每年一次再平衡回目标 |
| S2 — 抽屉党(漂移) | 60/70/80% | 其余 | 从不再平衡 — 仓位自行漂移 |
| S3 — 投降(真人) | 60% 计划 | 其余 | 按 S1 计划持有,直到自身权益回撤越过 ~35%,然后全部转稳定币;三种回归规则 |
| Aegis(v14) Shield | 动态 | 动态 | 生产配置,当日执行 |
S3 细节:痛苦阈值 35% ± 5 个百分点,按种子抖动(30 个种子)。 回归变体:永不回归、只在组合创历史新高时回归(买在顶上)、 或离场一年后回归。回归后计划继续执行,人还可以再次违约。
S2 值得一句话:牛市里风险腿不断长大,"设完就忘"的 60/40 会在顶部 附近悄悄变成 ~90/10 — 满仓撞上崩盘。这种漂移不是稻草人,而是静态 分配在现实中最常见的版本。
3. 结果 — 机器人与抽屉党
| 策略 | MaxDD | 夏普 | Calmar | CAGR | 最终 |
|---|---|---|---|---|---|
| BH | 81.5% | 0.475 | 0.510 | 41.6% | $74,199 |
| S1 60/40 机器人 | 60.7% | 0.621 | 0.643 | 39.1% | $66,241 |
| S1 70/30 机器人 | 66.7% | 0.585 | 0.600 | 40.0% | $69,163 |
| S1 80/20 机器人 | 72.2% | 0.549 | 0.565 | 40.8% | $71,501 |
| S2 60/40 抽屉 | 80.5% | 0.452 | 0.482 | 38.8% | $65,595 |
| S2 70/30 抽屉 | 80.8% | 0.458 | 0.489 | 39.6% | $67,746 |
| S2 80/20 抽屉 | 81.1% | 0.464 | 0.497 | 40.3% | $69,897 |
| Aegis(v14) Shield | 34.2% | 0.493 | 0.659 | 22.5% | $30,121 |
三个突出的事实:
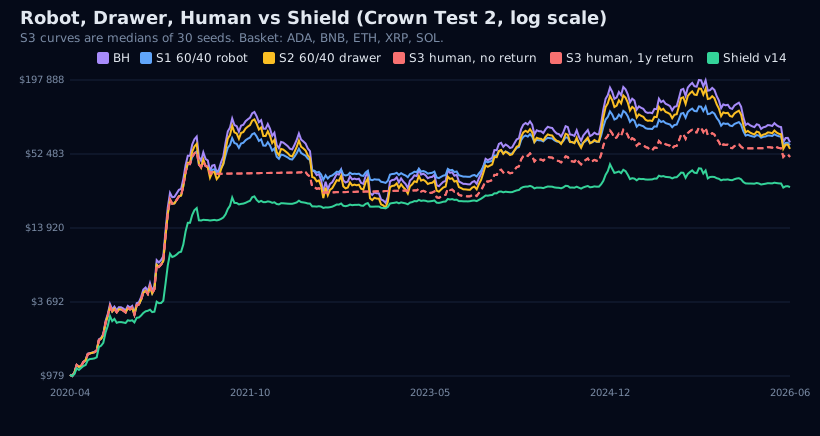
1. 机器人很强。 每年只再平衡一次的教科书 60/40,夏普是这里测试 的所有策略(包括防护盾)中最高的。6.2 年里 6 次再平衡,手续费 $48。 2. 漂移吃掉的是防护,不是收益。 抽屉变体的最终金额与机器人相差 无几(60/40 只差 −$646),却承受了几乎完整的买入持有回撤 (80.5% 对 60.7%)。年度再平衡买来的是痛苦削减,不是收益。 3. 防护盾是唯一 MaxDD 低于 35% 的策略 — 而它为此付了钱。 2,275 天中 1,758 天处于防守状态(77%),最终权益不足机器人 60/40 的一半。
4. 结果 — 真人
S3 操作者严格按机器人的计划执行,直到自身权益回撤越过 ~35% (实际触发阈值中位数 34.0–34.2%),然后把所有风险资产换成稳定币。 30 个种子的中位数:
| 回归规则 | MaxDD | 夏普 | 最终 | 相对自身计划的损失 | 投降次数 | 离场天数 |
|---|---|---|---|---|---|---|
| 永不回归 | 60.4% | 0.562 | $53,768 | $16,404($2.3k–$19.0k) | 3 | 1,837 |
| 创新高时回归 | 65.7% | 0.564 | $52,376 | $15,206($8.6k–$24.9k) | 5 | 1,682 |
| 一年后回归 | 60.4% | 0.582 | $53,768 | $12,473($6.4k–$19.0k) | 4 | 1,838 |
慢慢读:
- 每一个人都违约了。 30 个种子、三种回归规则 — 没有一个模拟的 人把 60/40 撑过了痛苦。每个生命周期中位数 3–5 次投降。
- 他们约 81% 的时间不在市场里(2,275 天中的 1,682–1,838 天)— 却仍然在崩溃之前经历了 60–66% 的回撤。
- 违约的代价是 $12.5k–$16.4k — 相对同一个计划被机器人式地执行。 "创新高再回归"的 MaxDD 最差(65.7%),因为它系统性地买在顶部。
5. 门槛记分卡
原测试计划中的通过标准,逐字引用:
| 门槛 | 要求 | 结果 | 判定 |
|---|---|---|---|
| MaxDD | 防护盾 < 全部静态 | 34.2% 对 60.7–81.1% | ✅ 通过 |
| Calmar | 防护盾 > 最佳静态 | 0.659 对 0.643 | ✅ 通过 |
| 夏普 | 防护盾 ≥ 最佳静态 | 0.493 对 0.621 | ❌ 失败 |
| 最终权益 | 在最佳静态的 80–120% 区间内 | 仅为最佳的 45% | ❌ 失败 |
4 过 2。 防护盾在每一个衡量痛苦的指标上占优,在这个窗口的每一个 衡量终端财富的指标上落败。
6. 诚实的解读
1. 防护是真实的,且是同类中最强的。 MaxDD 34.2% 对每一个静态 变体的 60.7–81.1%,Calmar 是九个策略中最高的 — 真正坐穿的痛苦 换来的最佳回报。这是产品的承诺,本次测试确认了它。
2. 收益代价也是真实的,现在已被量化。 在一个包含两轮巨型牛市的 6.2 年窗口里,恒定敞口得到了奖赏。防护盾 77% 的时间处于防守, 2,275 天中有 2,268 天落后于买入持有,最终比机器人 60/40 少约 $36k。按这份数据,任何能面不改色扛住 61% 回撤的人,都应该选择 机器人。测试直说了。
3. 机器人并不存在。 30 个模拟人类中没有一个撑住计划。他们投降 3–5 次,每人放弃 $12.5k–$16.4k 的权益,约 81% 的时间待在稳定币 里 — 仍然承受了 60–66% 的回撤。因此诚实的比较不是"防护盾 vs 机器人 60/40",而是"防护盾 vs 一个人实际会用 60/40 做的事": $30,121、34% MaxDD,对 ~$52–54k、60–66% MaxDD,外加三次对自己 失信。
4. 这意味着什么。 防护盾不是收益最大化器,本测试拒绝假装它是。 它是痛苦管理器 — 在这个窗口里,为管理痛苦支付的溢价大约是 $30k 结果上的 $36k。这笔交易值不值,是个人风险偏好的问题; 数据现在给出了精确的标价。
7. 测试细节
- 组合: ADA、BNB、ETH、XRP、SOL(等权)
- 窗口: 2020-04-10 至 2026-07-04(2,275 天,6.2 年)
- 起步资金: $1,000 · 定投: 每 30 天 $100(完美)
- 手续费: 每笔交易 0.1% · 稳定币收益: 0
- S1 再平衡: 每 365 天回到目标;忽略 $1 以下的尘埃
- S3: 基础计划 = S1 60/40;投降阈值 35% ± 5 个百分点 (按种子);回归:永不 / 组合创新高 / 365 天;回归后计划继续, 可重复触发
- 防护盾: 生产
default_config,当日执行(即人为因素系列中 记录的操作要求) - 种子: 每个 S3 变体 30 个;确定性策略只跑一次
8. 可复现性
所有策略跑在同一段 6.2 年的日线收盘价上,防护盾腿使用未修改的 生产引擎。测试脚本、图表生成器与原始结果数据存放在引擎的内部 研究工具中;所有报告的中位数都来自 30 个种子。
这是 Aegis(v14)去杠杆防护盾五项计划皇冠测试中的第二项。测试 1(人为因素) 已发布于此处。本次判定:4 过 2 — 防护盾在防护与痛苦调整后收益上占优,收益门槛输给一个不存在的机器人, 并在除终端财富外的每一个维度上击败其竞争者的人类版本。下一项: 测试 3,流动性执行。